01 · 基模升级
更强基模,带来能力增量
- 吸收通用基模在空间理解、推理与任务组织上的持续进步。
- 通过统一接口接入更强基模,复用已有的场景状态、记忆与技能体系。
验证方式:同一系统更换基模,对照任务表现与适配成本。
Confidential
请输入机构专属访问密码。
迈向开放世界的通用具身智能
Orchestrating Perception · Prediction · Action
协律感知、预测与执行 —— 让机器人与环境、与人协律而行
ORCHTECH / CORE THESIS
通用机器人的终极形态
理解环境与物体的随机性,形成鲁棒的感知—动作闭环;再将新技能扩展至更多真实场景。
The Thesis
能力边界正在迁移
固定场景、固定任务 → 开放世界
短动作执行 → 长程自主任务
依赖专家数据 → 自主理解、规划和恢复
端到端模仿学习直接生成动作的范式(如 VLA、WAM),泛化效果仍受训练数据覆盖范围影响,开放、长程任务的可靠性需要在真实扰动中验证。通用基模持续增强的理解、推理与任务组织能力,为机器人系统提供不断升级的通用智能。
Click to reveal core judgment 01
OrchTech Route
围绕持续进步的通用基模,组织空间理解、长短期记忆、预测规划与专家技能
吸收通用基模的理解与推理能力,构建带几何尺度的 3D 场景关系图(Scene Graph);结合短期记忆,持续维护对象状态、任务进度与环境变化。
基于 JEPA 的自有模型在潜空间预测动作引起的场景关系变化;结合长期记忆中的交互经验与恢复方法,规划移动操作空间轨迹、编排技能并处理失败。
以专家技能(Skills)与控制器满足实时性、精度和接触要求;回传执行结果,将已验证的交互经验沉淀为可复用的记忆与技能。
以统一信息接口与长短期记忆,贯通空间理解、预测规划与动作执行。
短期记忆维持当前任务状态,长期记忆复用已验证的交互经验与专家技能。
行业趋势
主线一 · ROBOTICS HARNESS
系统架构从更大的端到端动作模型,转向显式的分层分工。
语言模型进入机器人决策栈
双系统成型:慢速语义推理 + 快速动作专家
同一冻结 VLA 加入编排器,LIBERO-PRO 12.8% → 53.3%
ER2 语义规划与进度跟踪,VLA 负责执行
主线二 · PREDICTOR + PLANNING
从预测像素、拟合专家数据并直接生成动作,转向预测行动带来的世界变化;动作生成则由 Planner 模块通过与模型交互的最优化计算过程完成。
2018 年图灵奖得主提出:预测表征而非像素
把「预测未来像素」替换为「预测未来表征」
冻结视觉基座 + latent dynamics,验证 zero-shot planning
百万小时视频预训练 + 62h 机器人数据
仅两项 Loss、约 1500 万参数,规划降至 1 秒内
两条主线的完整技术 review 见 Data Room
第一章 · CHAPTER 01
在开放场景移动操作与复杂交互规划领域具备系统级顶尖积累。 团队具备贯通 System 0–2 的系统级全栈经验,覆盖底层实时控制、专家技能执行与高层任务推理规划。
长程连续移动操作
真机连续搬运 32 把椅子、近 40 分钟不中断,全程实时纠偏
模型 · 抓取偏差自适应 / 控制实时调整工程 · 高频闭环 / 长时稳定运行
跨空间移动操作
真机跨空间自主移动并完成推椅子任务,在环境变化与扰动下保持稳定闭环
模型 · 跨空间任务泛化 / 交互决策工程 · 移动操作协同 / 抗扰控制
真实有人环境作业
办公场景边移动边操作,处理多重接触与扰动
模型 · 复杂环境感知工程 · 复杂多任务
灵巧手精细操作
物体旋转等接触丰富的精细操作
模型 · 接触自适应工程 · 灵巧手闭环控制
跨本体执行
同一策略直接驱动腿式整机完成同类任务
模型 · 跨本体策略工程 · 整机控制
单策略跨物体泛化
同一 policy 推形状、材质、重量各异的物体
模型 · 多物体泛化工程 · 鲁棒接触控制
模型泛化与机器人工程的深度耦合:既能应对变化与扰动、实现跨本体泛化,也能在复杂接触和长程任务中稳定运行。
团队现有十余人,成员来自香港科技大学、香港大学、新加坡国立大学等高校,具备华为、小鹏、腾讯等大厂经验。具备感知、理解、规划、控制系统级全栈能力,在开放场景交互式移动操作方面的积累处于业内领先水平。
技术与产品战略总负责人
哈佛访问学者 · 新国立博后 · 港科大博士 · UCSD 硕士
机器人总负责 · 技术架构与系统闭环
港科大博士后 & 博士 · 中科院大学硕士 · 戴盟联创 · 小鹏
具身模型总负责 · JEPA 预测器训练
港大博士 · 港科大硕士 · 上海 AI Lab
港深地区人才密度最高、规模最大的 Robotics & AI Lab
公司是马骏教授唯一绑定的产业转化平台,创始人为其第一位学生。核心团队同门并肩多年,决策与执行同频
第二章 · CHAPTER 02
目前行业核心三条技术路线的演化历史
能力增长 · VLM × ROBOTICS
以空间理解、长短期记忆与专家技能,将持续进步的通用智能转化为开放场景中的长程任务能力。
01 · 基模升级
验证方式:同一系统更换基模,对照任务表现与适配成本。
02 · 机器人经验积累
验证方式:固定基模,对照经验积累前后的完成率、人工接管与任务成本。
协律的持续积累:以机器人学与系统经验吸收基模进步,让已验证的物理交互经验持续服务后续任务。
完整分析与测试见 Data Room
海外三类均有顶级机构推进;国内创业公司高度集中在前两类
视频规划
作为视频规划器与逆动力学模型(IDM)联合使用,由渲染预测的未来视觉状态反推可行动作,常用于灵巧手操作。
端到端规划
依靠大量专家数据覆盖任务分布,端到端生成动作,跳过机器人"感知-预测-规划-执行"闭环系统的中间环节,适用于固定场景固定任务。
预测 + 规划
基于 JEPA 的隐空间状态预测器 + 规划架构,预测器层理解不同动作下交互状态如何演化,规划层基于预测结果规划最优动作并完成闭环执行。
国内多数隐空间世界模型仍以端到端 / RL 监督动作;协律科技依托在开放场景移动操作与复杂交互规划领域的系统级顶尖积累,解耦预测与规划以及动作执行,实现跨场景推演与高频鲁棒执行。
分层(hierarchical)及Predictor+Planning是独立的研究方向,且高速增长
WAM 相关的研究增长迅速,得益于 VLA 创业公司比较多,范式迁移简单,也因此业界声量少。
Predictor + Planning 相关的研究在 LeWM 后快速上涨,但业界声量相对少,主要系相关创业者很少,传导速度有限。
代表演化:Code as Policies → SayCan → VLM + tools → Gemini Robotics 2
代表演化:V-JEPA → V-JEPA 2 → V-JEPA 2-AC → LeWM → JEPA + Planner
代表演化:RT-1 → RT-2 → Open X-Embodiment → OpenVLA → π0 → Gemini Robotics
代表演化:GR-1 → GR-2 → UniPi → Genie 2 → WorldVLA → DreamZero
数据口径:Google Scholar / arXiv · 2025.01—2026.07
第三章 · CHAPTER 03
通过空间理解、长短期记忆、预测规划与专家技能,把通用智能转化为鲁棒的物理执行。
世界是什么样,机器人应该做什么
空间理解与短期记忆:结合 VLM 与 3D 观测构建带尺度的场景关系图,持续维护对象状态、任务进度与环境变化。
做了之后会发生什么,据此该走哪条路径
Predictor + Planner:基于 JEPA 预测动作后的场景变化,结合长期记忆中的交互与恢复经验,规划空间轨迹和技能顺序。
如何以高频、稳定、安全的方式执行
专家技能与反馈:调度技能库与全身控制器,适配物体与本体的接触差异;执行结果用于重规划、技能验证与经验积累。
分层的泛化与积累:同一高层意图可适配不同物体与本体;已验证的交互经验通过长期记忆与技能库复用,支持跨任务、跨场景的持续扩展。
差异化 01
以 Relation 作为核心世界表征
学什么 · Relation 表征
世界最本质的表征不是像素,也不是把视觉、语言和物理属性全部塞进模型,而是机器人、物体与环境之间的关系。系统从视觉、语言和 3D 信息中提取空间、拓扑、因果、通行和交互关系。
怎么学 · JEPA
让 JEPA 学习这些关系在机器人动作作用下如何变化,再结合预测和规划产生动作。不以专家数据为前提,因此更容易迁移到新的任务、物体和场景。
以椅子为例
不需要预测椅子移动后的每一个像素,只需要判断
椅子是否更靠近桌子
移开后通道是否打开
当前动作是否让任务更接近完成
既过滤了与决策无关的细节,又保留了规划真正需要的信息,使同一套模型可以跨物体、跨任务和跨场景复用。布料操作中的 topology,就是关系表征已经跑通的一个特例。
差异化 02
让不同尺度的问题,在合适的层解决
单体端到端模型
协律 · 分层协同系统
跨任务迁移
本体相关 · 高频闭环
✕尺度冲突
长程推理与接触控制,压进一个网络互相拖累
✓按尺度分工
上层泛化关系,底层泛化控制
✕误差无缓冲
仿真与现实的接触差异,直接传导为执行失败
✓底层吸收 gap
高频闭环解决真实接触差异
✕牵一发动全身
加技能、换本体,任何改动都要整套重训
✓各层独立迭代
升级单层即可,无需从头重训
面对开放世界无法穷举的任务空间,仿真交互数据是更低成本、更能泛化的路线
模仿学习积累的是示教轨迹,会随任务与本体变更而贬值;关系表征与数据管线可跨物体、跨任务、跨场景复用,是真正随时间复利的资产。
第四章 · CHAPTER 04
最新进展 01 / 05
场景理解、任务与空间轨迹规划、移动操作技能协同运行
视频暂时无法播放,请刷新后重试。
仿真闭环验证一句「整理会议室」,从自主进门到整理完成
最新进展 02 / 05
同一套框架、同一条「整理会议室」指令,在不同桌椅布局与物体配置下闭环执行。
视频暂时无法播放,请刷新后重试。
多配置仿真验证改变环境配置,保持任务指令与系统框架不变
最新进展 03 / 05
依据物体拓扑、语义与当前状态在线计算交互方式,适配不同机器人本体。
视频暂时无法播放,请刷新后重试。
物体理解与本体约束结合在线选择交互部位、接触方式与可达方案
最新进展 04 / 05
将全身参考轨迹映射到不同机器人本体,验证双臂、躯干与底盘的协同跟踪。
视频暂时无法播放,请刷新后重试。
Whole-body Tracking · 仿真验证跨本体的全身运动重定向与轨迹跟踪
最新进展 05 / 05
轮式双臂本体与天玑 Luna 同步推进,展示实机形态与运动控制进展。
实机运动演示
视频暂时无法播放,请刷新后重试。
实机遥操作演示
视频暂时无法播放,请刷新后重试。
让具身机器人在开放场景中自主完成真实世界需求
从数学本质角度出发
“看到这个状态,专家当时做了什么?”
状态:st 动作:at
专家轨迹:τ* = (s0, a0, s1, a1, ···)
使用神经网络学习直接映射关系
VLA 和 WAM 的本质是状态 s 不一样
VLA:在 s 状态下,正确答案是 action a*
WAM:在 s 状态下,st+1 会变成什么,以及正确答案是 action a*
“做什么动作,世界会怎么变化?”
“哪一条路径能达到目标?”
状态:st 动作:at 目标:g
需要有一个 Predictor 进行推理
搜索不同的动作,预测不同后果
先判断哪一个 st+1 能达成目标 g,再比较哪一条路径最优
在 s 状态下,输入 a,st+1 会变成什么?
两者的泛化性来源与核心瓶颈
为什么容易出现“分布外崩溃”?
如果训练集有:
模型学会:A → B,B → C,C → D
但实际执行:A → B′
模型并不知道:B′ → C
泛化思路是学习:B′ / B″ / B‴ / B⁗ → C
举例:如果训练集有
模型做不到
学习 B′ -> B⁗⁗⁗
“海量数据”
模型学会:
A → B
A → C
A → D
但实际执行:
B、C、D 谁最接近 goal
理论上具备前者没有的一项能力:
组合已有知识,产生训练数据中没有的 action sequence
举例:如果训练集有
模型预测如何到达目标位置 goal
模型能否正确预测未来?
也需要数据,但不需要左侧那么多;模型理解模糊意图即可,因为 Planning 可以补齐中间状态的 dynamic。
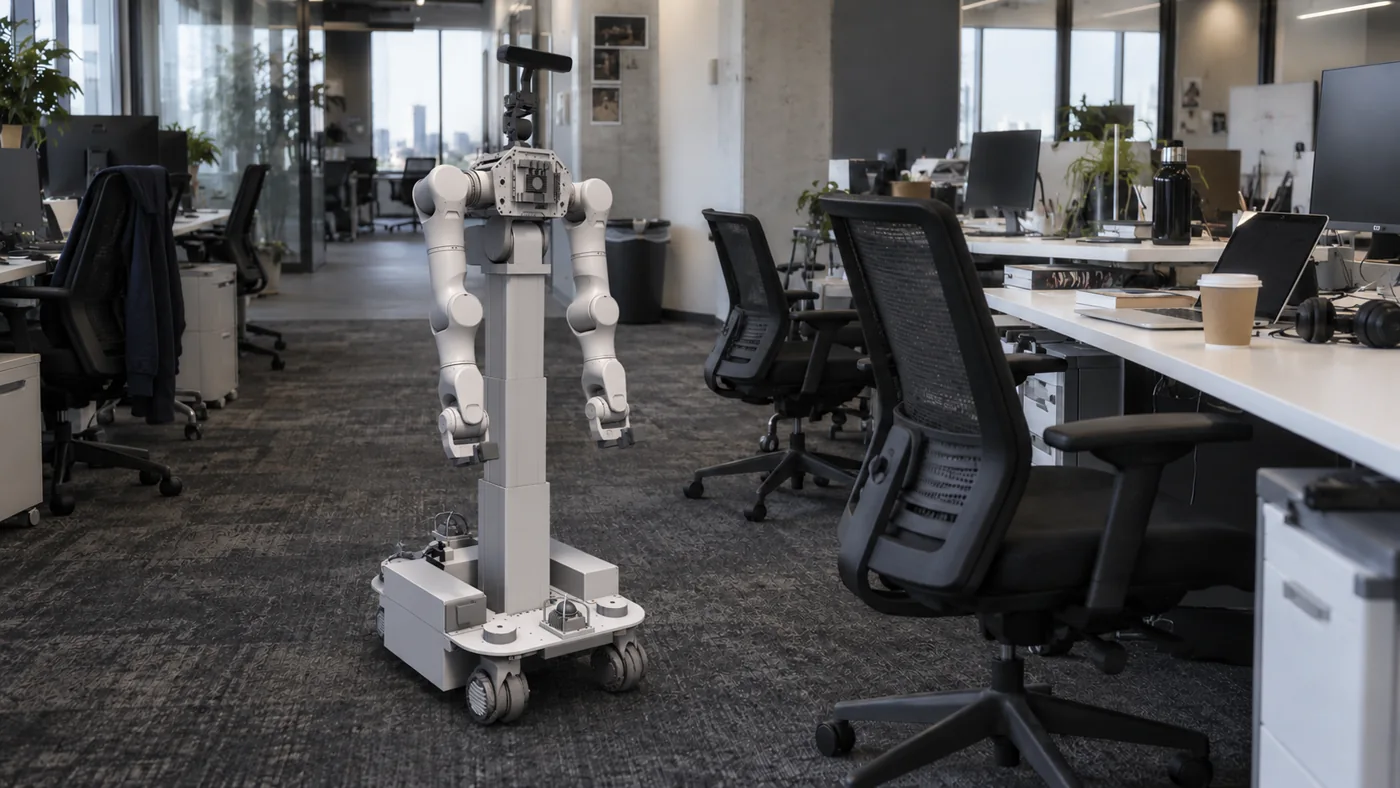
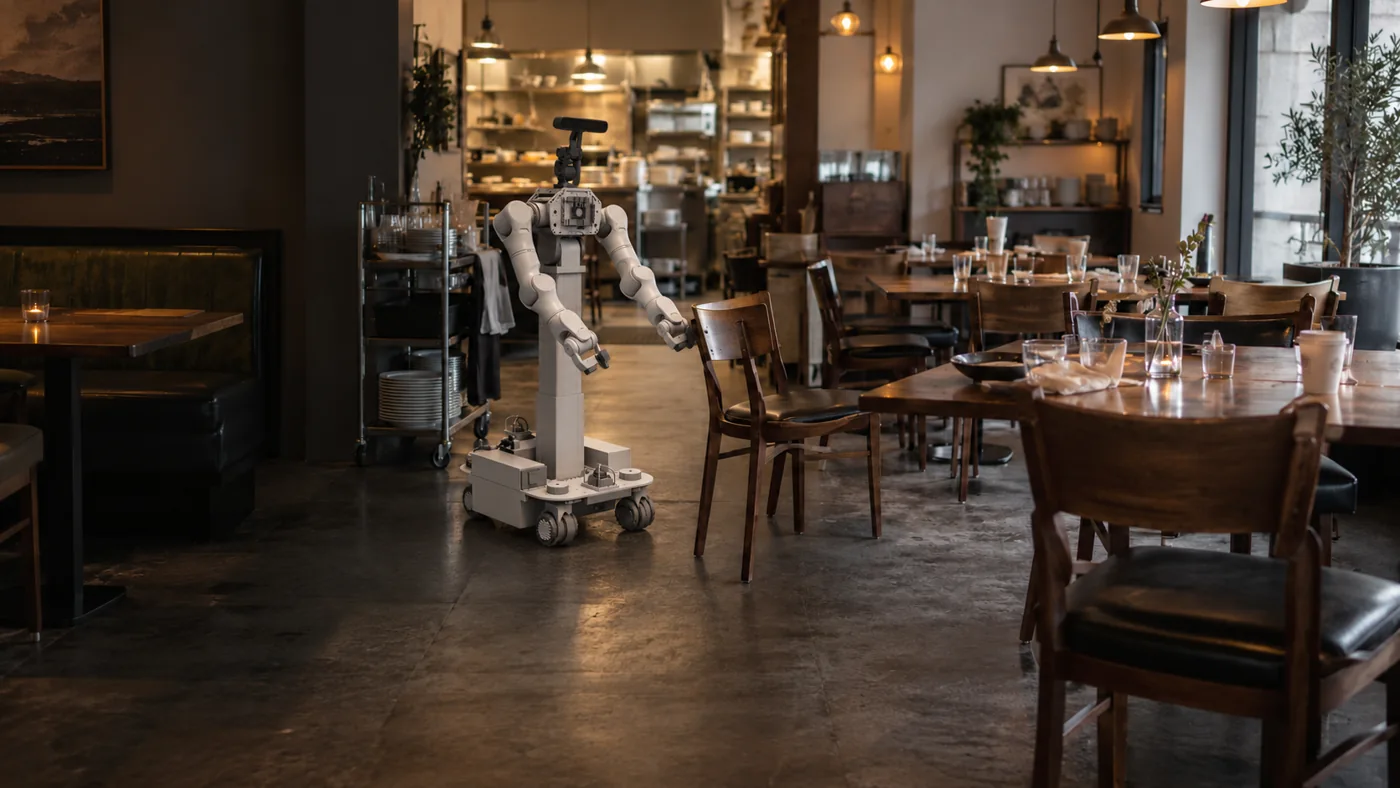
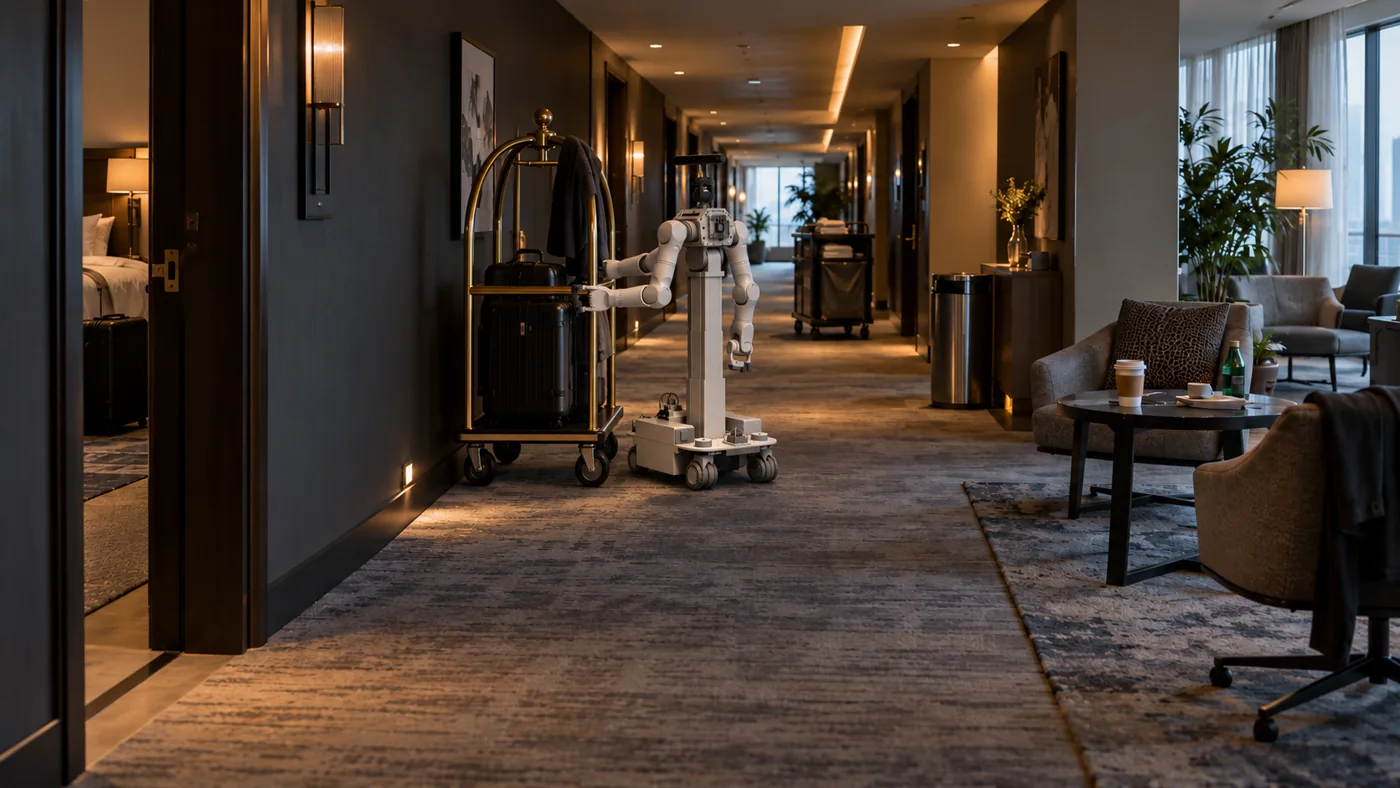
以会议室完成开放场景的系统验证,再基于通用能力扩展技能,进入写字楼、餐厅和酒店等服务空间
阶段一 · 0—3 个月
以会议室的随机布局和多种操作任务,验证开放世界理解与移动操作的完整闭环
陌生布局理解,以及开门、推拉、抓取、放置等移动操作
同一系统在不同布局与物体组合中持续完成任务,不依赖固定场景脚本
通用开放世界理解与移动操作底座
阶段二 · 3—6 个月
沿用统一架构,把会议室能力扩展到商业写字楼与更多服务任务
将已验证的交互经验沉淀为长期记忆与可复用技能,扩展任务与场景
加强真实交互采集、预测模型训练与技能验证,提升长程任务稳定性
可复用技能库、数据闭环与部署工具链
阶段三 · 6—12 个月
融资后选择需求明确、价值可衡量的细分行业形成标准产品
餐厅、酒店等高频服务场景,优先验证客户付费意愿与部署条件
复用通用底座,按行业增加技能与工作流,避免重复搭建整套系统
细分行业解决方案与付费客户试点
阶段四 · 12—24 个月
复用通用能力底座,以配置和增量技能替代从头研发
商业写字楼、餐厅、酒店及其他半结构化服务空间
复用场景表征、交互经验与专家技能,降低新场景的适配与部署成本
标准产品组合与规模化交付体系
概念形态与真机原型
概念形态
Concept
原型 · 上下坡
Prototype
原型 · 不平整地面
Prototype
Concept
轮式底盘与双臂统一调度,高度可调,适配办公、商超、家居等空间。
Performance
上下坡、不平整地面等移动能力,以及双臂协同操作,均已在真机验证。


